

Privacidad con los proveedores de modelos
Última actualización: 28/09/2026
La privacidad es importante para nosotros.
Estamos en Europa, cuna del RGPD.
Nuestros ingresos proceden de las suscripciones que pagas, no de ninguna otra fuente.
No entrenamos modelos propios ni utilizamos tus conversaciones para entrenar ningún modelo. Tus prompts solo se almacenan para que puedas consultar tu historial y puedes eliminarlos cuando quieras.
Para conocer en detalle qué datos recopilamos, cuánto tiempo los conservamos, cuáles son tus derechos y qué medidas de seguridad aplicamos, lee nuestra política de privacidad. Esta página se centra en una cuestión que la política de privacidad solo aborda de forma general: ¿qué hacen los proveedores de modelos de IA con tus prompts?
Qué reciben los proveedores de modelos
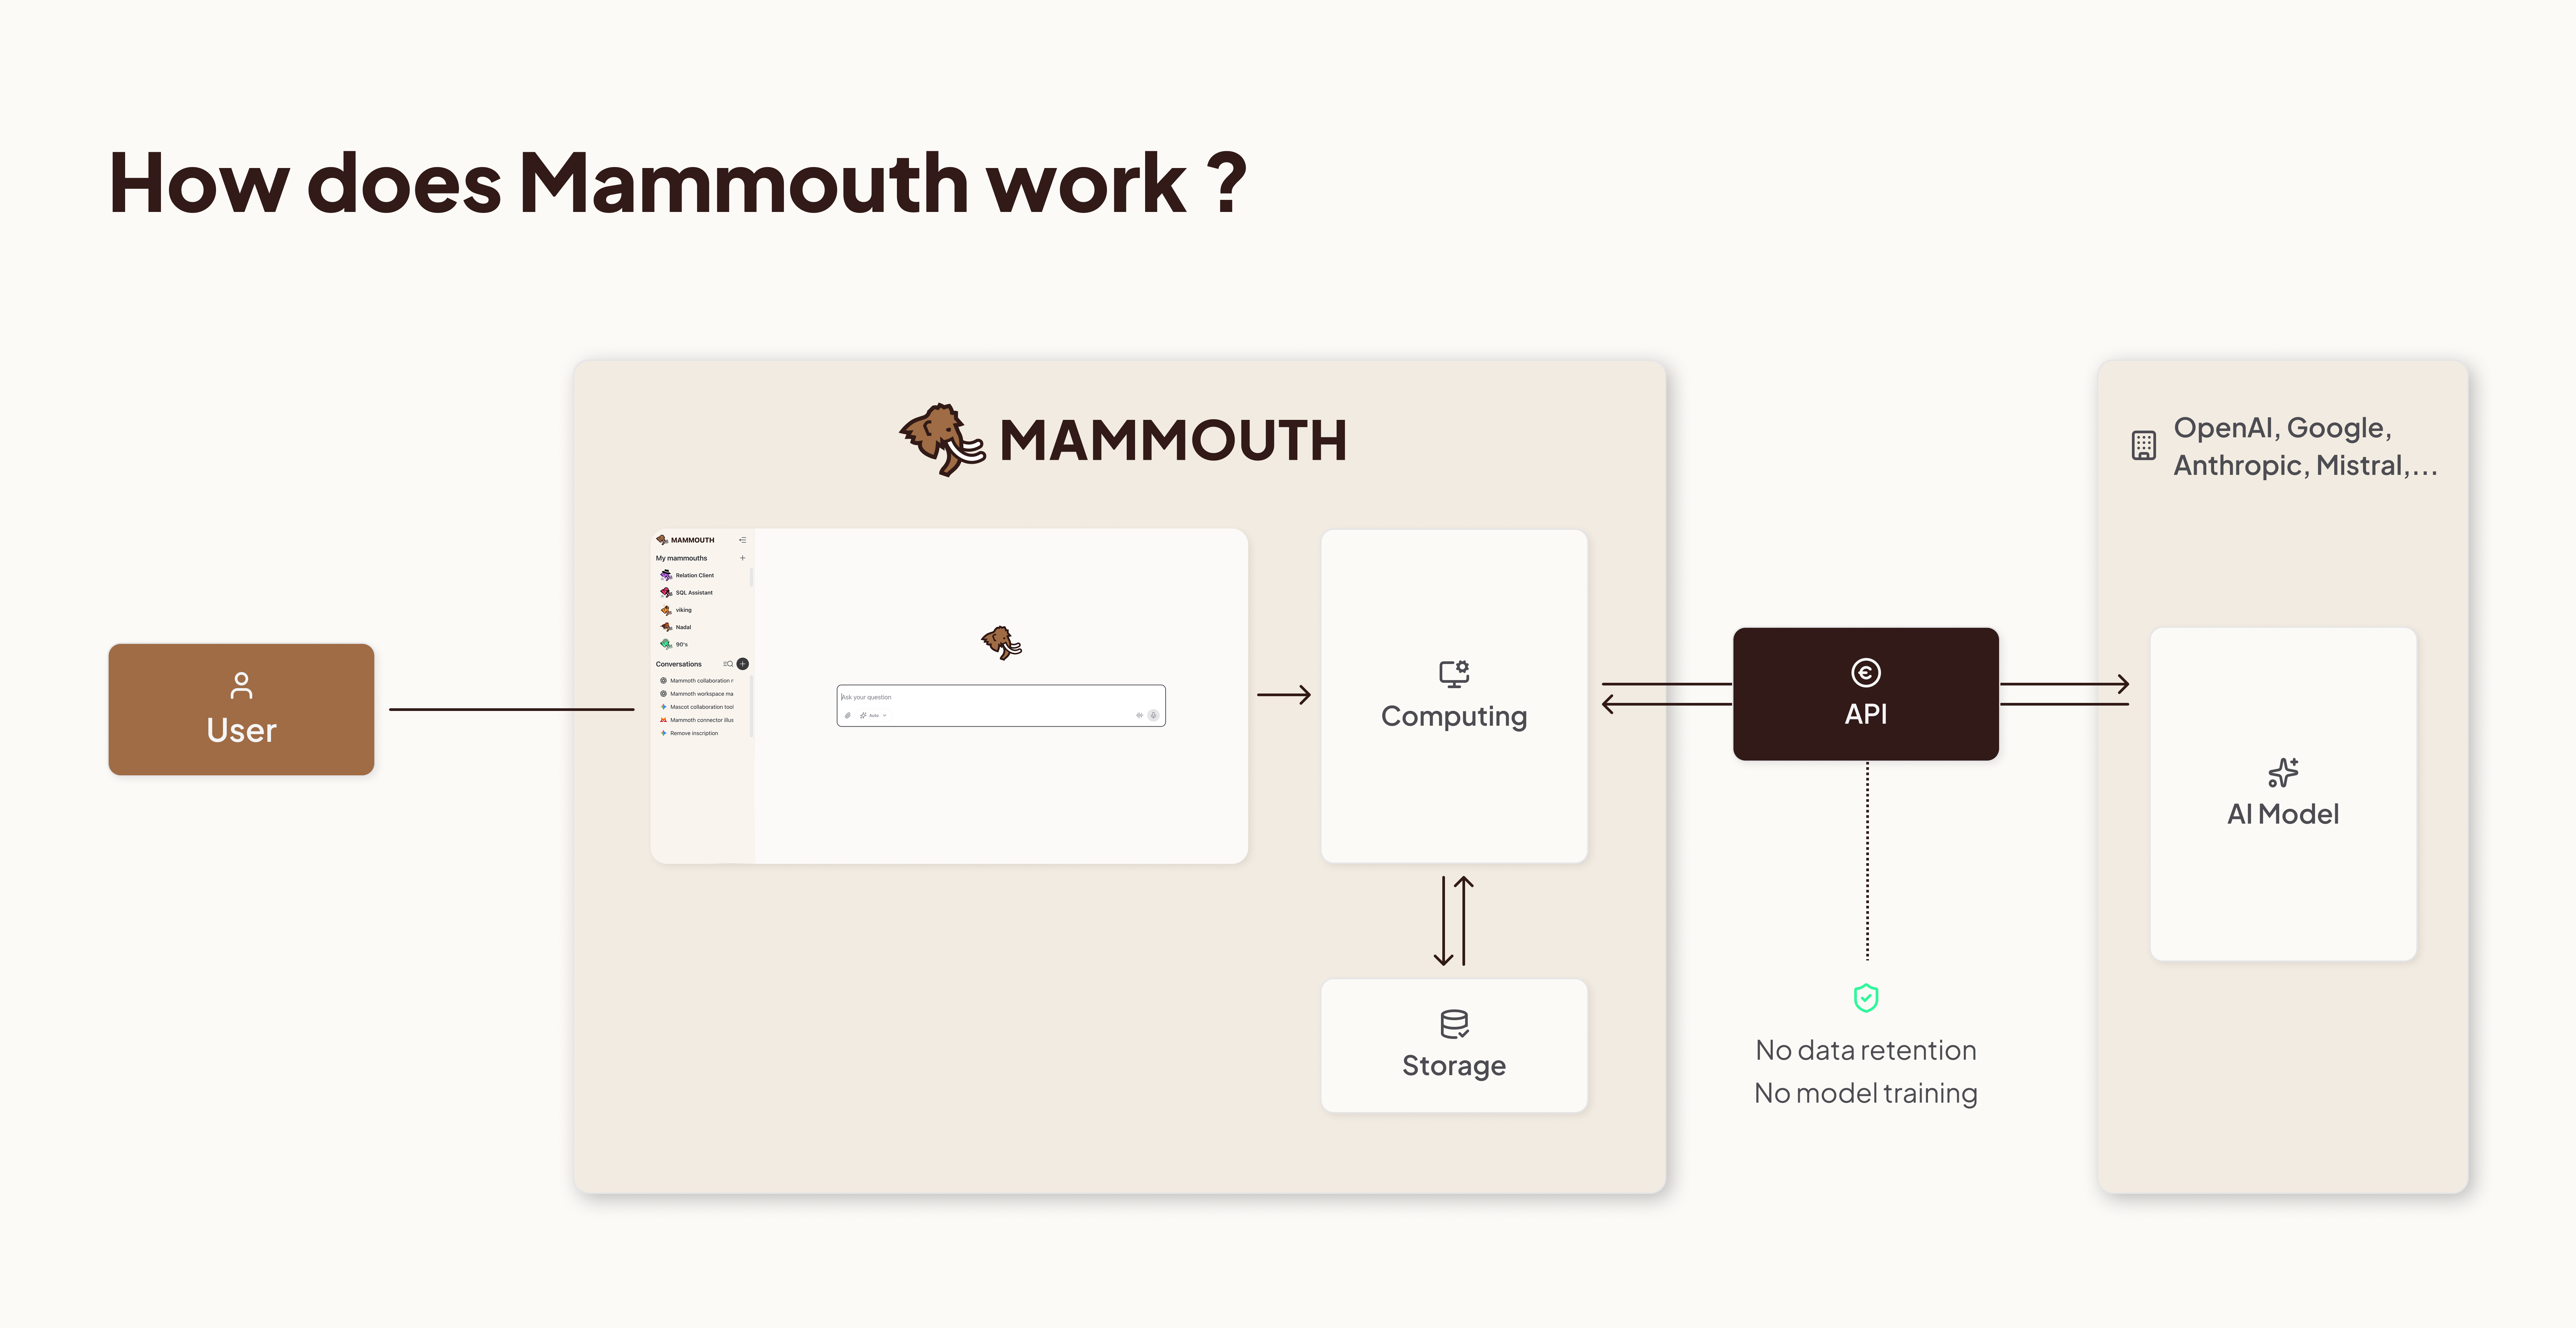
Los proveedores solo reciben la información necesaria para responder a tu solicitud: tu prompt, el historial pertinente de la conversación, fragmentos de documentos y las instrucciones personalizadas aplicables.
No reciben tu identidad, tu identificador de usuario de Mammouth, ni los identificadores de la conversación, del equipo, del proyecto o de los archivos. Para prevenir abusos, pueden recibir un identificador de usuario completamente anonimizado.
Tu contenido se procesa sin asociarlo a tu identidad de Mammouth.
Qué hacen los proveedores de modelos con tus prompts
En Mammouth nos centramos en ofrecer dos garantías principales sobre los prompts:
- No se entrenan modelos con los prompts enviados a Mammouth.
- Política de no retención de datos: los proveedores no conservan los prompts de Mammouth durante más de 30 días; por lo general, los registros se utilizan para supervisar el uso indebido del servicio.
Como utilizamos modelos de IA propietarios, debemos cumplir las políticas de privacidad de sus proveedores, que varían de uno a otro. Las hemos revisado; este es un resumen de las principales:
- OpenAI: «Tú tienes la propiedad y el control de tus datos… Los datos enviados a la API de OpenAI no se utilizan para entrenar ni mejorar los modelos de OpenAI». Consulta Privacidad de la API de OpenAI.
- Mistral: pagamos por su servicio de API. Su política (artículo
2.2.2.2 Nuestros servicios de pago) establece: «No utilizamos tus datos de usuario para entrenar, mejorar ni perfeccionar nuestros modelos». Solo conservan los datos durante 30 días para supervisar el uso indebido. Nos encanta Mistral. - Anthropic Claude: cumplimos las Condiciones de servicio comerciales, que establecen (A. Servicio, 4.): «Anthropic no puede entrenar modelos con el contenido de los clientes de los servicios de pago».
- Gemini: lo utilizamos a través de Google Cloud API. La documentación de Google sobre gobernanza de datos indica que «Gemini no utiliza tus prompts ni sus respuestas para entrenar sus modelos». Más información sobre la gobernanza de datos de Gemini.
- Los modelos DeepSeek y Llama son de código abierto. El proveedor que usamos para servirlos es Fireworks (o, en algunos casos, OpenRouter; consulta más abajo). Los prompts enviados no se utilizan para mejorar el modelo y no se conservan después de generarlo. Puedes consultar su política de privacidad aquí.
- OpenRouter se utiliza como capa de enrutamiento de API. Por defecto, OpenRouter no conserva los prompts ni las respuestas y no los utiliza para entrenar modelos. Puede transmitirlos a proveedores de modelos posteriores, pero nos aseguramos de que estos cumplan las políticas de no entrenamiento y no retención de datos indicadas anteriormente. Consulta la documentación de OpenRouter sobre la recopilación de datos.
Lee nuestra política de privacidad o ponte en contacto con nosotros si necesitas más información u orientación.
El equipo de Mammouth